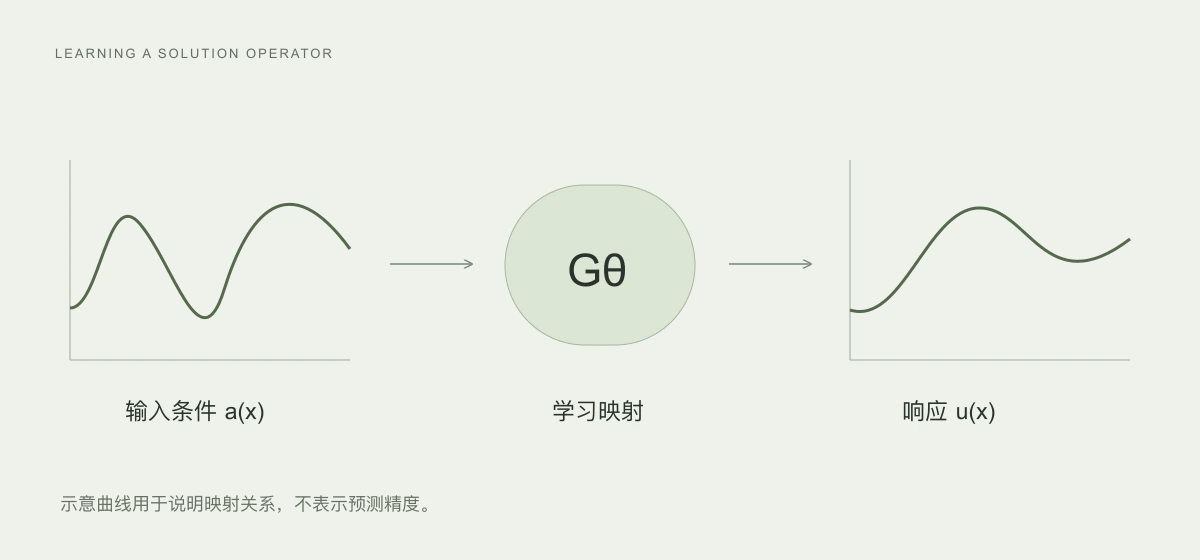
设想工程师正在比较几种运行设置。每一次调整都要重新计算,等待成本会影响他愿意尝试多少方案,也会影响团队怎样讨论边界条件。如果某些计算可以更快完成,工作方式确实有机会改变。问题随之转向:这些快速结果足够支持哪一种选择?
神经算子值得关注,就在于它为学习物理系统的输入与响应关系提供了一条研究路径。不过,“算得快”与“应该在什么地方使用”,仍需要分开回答。
学到的是一类输入与响应之间的关系
Kovachki 等人在 JMLR 发表的论文研究函数空间之间映射的学习,称这类方法为神经算子。一个应用是学习偏微分方程的求解映射:给定输入条件,近似得到相应的解。论文在若干方程任务中展示了预测表现与计算速度。
理解这项研究时,可以把注意力从“一次求解结果”移到“一类问题的对应关系”。这也提示了应用中的关键问题:手头输入与模型已经覆盖的条件有什么关系?当几何、材料或边界条件发生变化时,之前的验证还能说明什么?具体答案要由项目的数据和测试提供。
误差是否会改变方案的选择
对于工程决策,平均误差并不能表达所有需要知道的事情。一个模型可以在多数样本上表现稳定,同时在接近任务边界的少数样本上产生重要偏差。是否影响使用,取决于这些偏差参与了哪一步决定。
假设快速模型用来初步筛选候选方案,我们会特别检查它是否改变候选之间的相对排序,以及容易被筛掉的方案具有什么共同条件。若输出进一步参与运行参数的选择,就还需要与该用途相匹配的独立验证。两种场景可以使用同一个模型,但不能自动沿用同一份验收结论。
这是一项具体的设计建议,而非对某种神经算子的普遍性能承诺。项目应当先选定范围,把已有仿真或测量结果整理成基准,再查看误差在不同条件下怎样分布。发现缺少关键工况时,补数据或缩小使用范围都可能比继续优化一个总体分数更有意义。
数字孪生需要维护什么
将模型接入数字孪生之后,计算只是其中一部分。设备记录、参数单位、组件版本与模型输出,需要指向同一个对象。三维画面能够帮助理解这些关系,却不能独自证明关系正确。
一个实用的界面应当允许工程人员从异常返回当时的输入。那一刻使用的是哪版模型?哪些变量来自观测,哪些来自设定?数据更新延迟是否影响了显示?这些问题要求在运行记录里保留足够的上下文,而不是只存最终的一条曲线。
同样需要区分不同操作留下的证据。产品中的按钮和说明应当让使用者知道自己正在检查什么。
| 操作 | 可以帮助检查的问题 |
|---|---|
| 查看模型结果 | 这组输入得到了什么预测 |
| 回放已保存日志 | 记录中的软件过程怎样展开 |
| 固定条件重新运行 | 本次执行能否复现已有结果 |
| 与独立测量比较 | 模型在已测工况下存在什么偏差 |
这几类记录可以相互补充。展示了一段回放,并不自动完成重执行或实测比较;验收应按实际执行的操作记录结果。
更快之后,怎样安排验证
快速模型适合放在一个有后续检查的流程里:先在披露的范围内探索候选,再将值得继续的方案交给更充分的计算或实测。每次转交都应保留选取理由和输入版本,避免不同工具之间只传递一张结果图。
运行条件变化时,也要有明确的重新验证入口。更换部件、调整数据来源、改变使用目的,都可能影响原先结论的适用性。哪些变化需要重新检验,应在交付时和工程人员一起约定。
我们衡量这类系统的价值,会从一次实际决定往回看:它是否帮助团队检查了原本难以比较的方案,是否解释了重要的不确定性,是否保留了继续验证的依据。计算速度在这些问题里获得具体的意义。