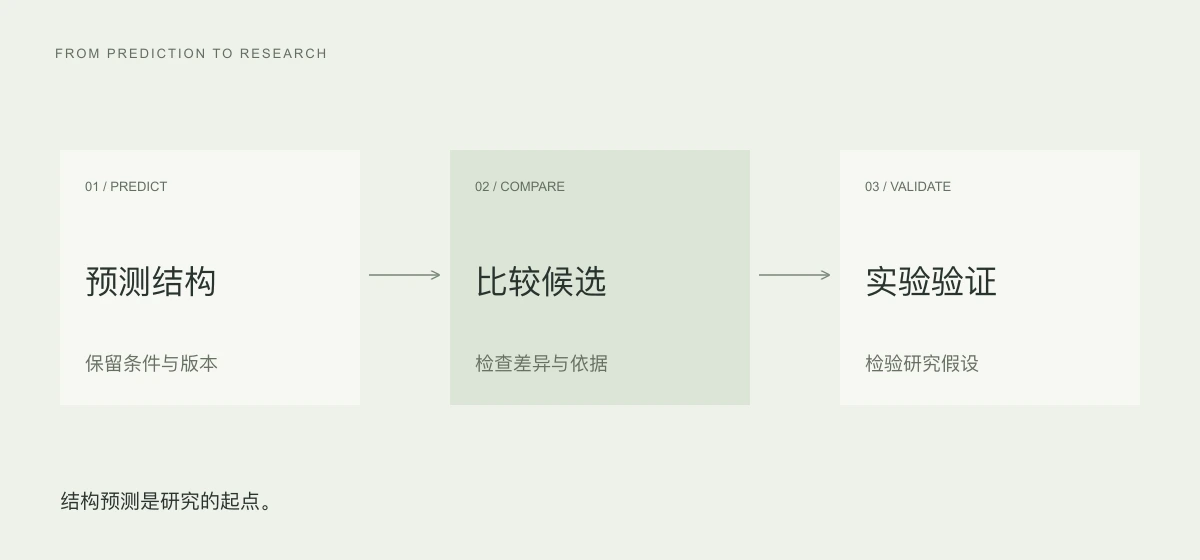
结构预测的进展,很容易被一张漂亮的分子图概括。图像呈现了一个答案,研究者手里的问题却往往还没结束:为什么这两个候选不同?哪一处值得继续检查?下一次实验应该验证什么?
阅读 AlphaFold 3 时,我们更关心这种变化对研究过程的影响。预测工具覆盖的对象越广,团队就越需要一种方式,把计算得到的结构放回产生它的任务里。否则,结果会越积越多,选取结果的理由却未必更清楚。
结构预测改变了比较的对象
2024 年 5 月发表的 AlphaFold 3 论文,在同一框架中预测包含蛋白质、核酸、小分子、离子与修饰残基的复合物结构。它扩展了能够共同建模的分子种类,也相应扩展了可以提出的问题。
这项进展的吸引力,在于分子关系可以被一起考察。对某项具体研究来说,结构预测提供的是需要解释和验证的信息;候选在实验中是否表现出预期性质,仍有自己的证据要求。
这里存在一个容易被界面掩盖的区别:一张图已经完整显示,并不意味着其中每个部分都具有同样的可靠程度。论文讨论了置信度评估,也讨论了生成模型可能产生看似合理结构的问题。把结果交给使用者时,表达不确定性的材料需要跟着结构一起出现。
一次预测应该保存成什么
假设一个团队要比较两组候选分子。最方便的交付是两个文件和一张对比图,但它们不足以解释差异。如果两次计算的输入、配置或模型版本发生过变化,比较的含义就需要重新检查。这是工作流程设计的问题,不能交给文件名碰巧记录。
我们会把一次计算组织为一份可复查的研究记录:它在回答哪个问题,输入来自什么资料,做过哪些清理,采用了什么配置,输出在哪里,以及谁对结果作过判断。这些内容应当能从结果页直接返回,而不必沿聊天记录寻找。
保存的粒度也有取舍。完整保留必要输入和运行配置,与无限复制所有中间文件,是两种不同的维护负担。项目开始时就应约定哪些信息足以支持复现,哪些信息用于解释结果,哪些可以在指定期限后清理。这样的约定,决定工具运行几个月后是否仍然可用。
对多人研究来说,负面结果同样需要可检索。某个候选为什么被放弃,可能比它曾经排在什么位置更有用。只有保留下选择的理由,后来加入的人才知道哪些尝试已经做过,哪些问题其实仍然开放。
下一次实验从哪一个差异开始
计算结果进入讨论后,产品应帮助研究者提出更具体的问题。例如,候选之间的差异是否来自输入变化;某个关键部位是否需要其他证据;当前结果是否足以缩小下一轮比较的范围。这些是应用设计的判断,不是 AlphaFold 3 论文已经为所有研究任务回答的问题。
验证也应围绕决定展开。工具如果用于整理线索,就检查线索是否准确、是否遗漏关键材料;如果用于辅助筛选,就需要和既有样本及独立方法比较,并观察错误会怎样影响筛选。单独测量计算速度,解释不了整个任务是否改善。
我们希望科研软件最终留下的,是一个能够继续工作的状态:研究者知道为什么保留某个候选,可以返回它的依据,也知道下一份证据应该从哪里取得。结构预测在这里成为研究过程的一环,后续判断仍然可以被追问和修正。