医疗 AI 的研究成绩,只有放回评价过程里才容易理解。看见一个系统在诊断或沟通方面表现出进展,接下来的问题是:它收到了什么信息,完成了什么任务,又由谁来判断结果?这些细节决定我们能把结论带到多远的地方。
AMIE 是一个适合这样阅读的例子。它把多轮诊断对话作为研究对象;读这篇论文,既需要关注系统表现,也需要认真看待表现产生的条件。
一次文字问诊中的比较
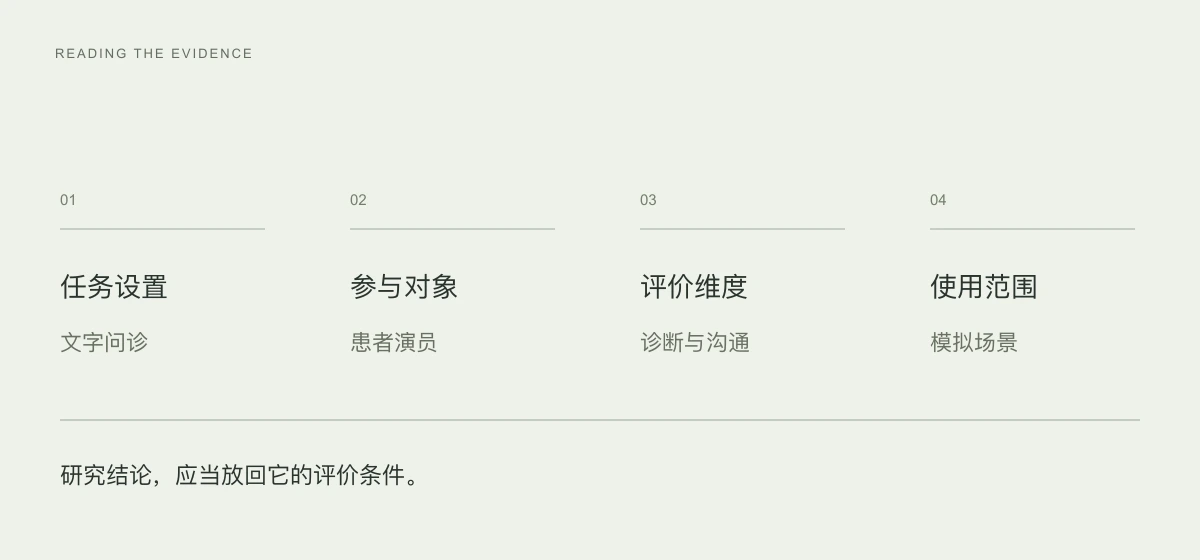
2025 年 4 月发表的 AMIE 研究,通过患者演员参与的文字问诊,对系统与初级保健医生进行随机、双盲交叉比较,并评价诊断与沟通等维度。研究在这一设置下得到积极结果。
作者明确说明,同步文字聊天与模拟患者的设计,不能代表日常临床实践。这个限定是解释结果的组成部分。把一种研究设置中的表现放进另一种工作环境,需要重新说明输入、使用方式和评价依据。
用途改变时,评价问题也会改变
我们做产品判断时,首先会把“医疗辅助”拆成具体任务。文献检索要检查引用是否对应;资料摘要要检查关键内容是否遗漏;研究数据审阅要保持记录与版本的关系。这些任务可以共享某些模型能力,但各自需要不同的验收材料。
假设需求是将指定文书整理为待审核的摘要。系统生成的文字流畅,只回答了很小一部分问题。审核者还需要知道某句话来自哪一段资料,是否遗漏时间条件,原文中的不确定表达有没有被改变。验证用例应当覆盖这些具体错误,而不只比较整段文字看起来是否合理。
AMIE 的研究不直接证明这个摘要产品有效。我们可以从研究中理解诊断对话的发展,再为手头这项用途设计独立验证。研究证据与产品证据各自清楚,讨论反而更容易推进。
专业人员怎样完成一次审核
一个常见的产品要求是“保留人工复核”。要实现它,界面需要提供核查所需的材料,也要给审核者明确的操作。原文、摘要和差异能否在同一工作上下文中查看?确认之后,后来发生的修改是否会重新进入审核?资料不足时,使用者能否停下来补充?
这些问题会改变数据结构和交互设计。例如,确认应关联一份确定的版本;否则,原文已经更新,页面上仍可能显示较早的确认状态。又例如,缺失信息需要能够被明确记录,不能只依靠审核者记得去追问。
我们会把审核所需的操作也纳入评价。一个工具节省了起草时间,却要求专业人员重新找齐全部依据,整体工作是否改善仍不清楚。应观察的是完整任务,包括核查、修订和交接。
错误需要进入改进记录
在真实使用中,用户发现的问题应该能够返回具体输出和当时的输入。团队需要区分资料本身不完整、检索没有找到、模型整理出错,以及界面造成误读等情况。它们要求的修正并不相同。
这类记录可以逐渐形成针对任务的验证样本。更新模型或流程时,团队再检查已经出现过的问题是否重现。涉及临床判断的应用,还需相应的专业验证与审核;工具的上线状态不能替代这些证据。
读完 AMIE,我们愿意继续跟踪诊断对话的研究,也更确定一项应用工作:把用途写得足够具体,把专业审核做成能够实际完成的操作。这样才知道下一次技术进展应当接入哪里。